
Research
Vision-language models for radiology report drafting
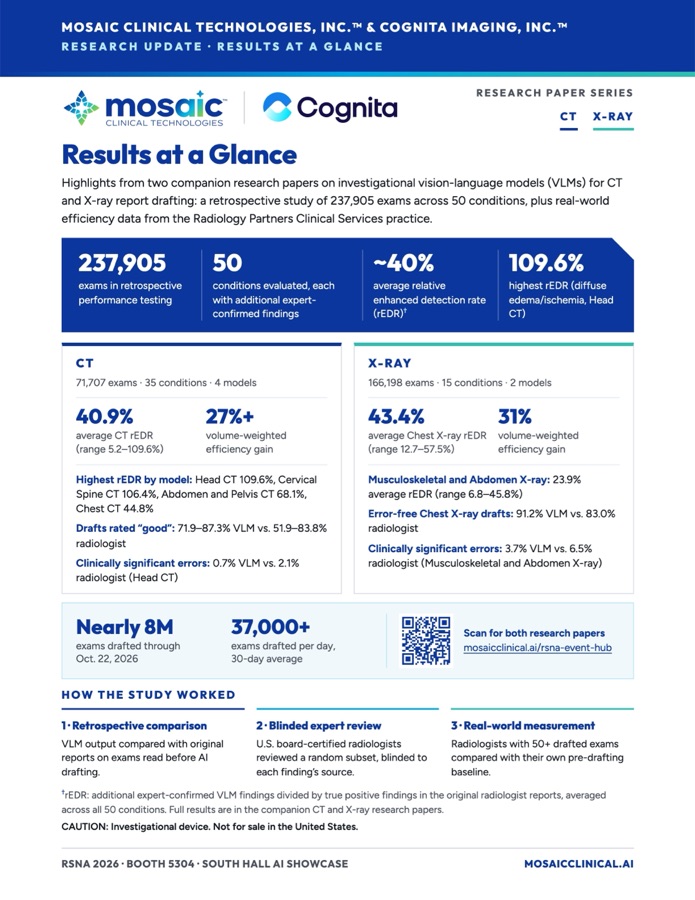
Two companion research papers from Mosaic Clinical Technologies and Cognita evaluate our investigational vision-language models (VLMs) for CT and X-ray report drafting. A retrospective study of 237,905 exams across 50 conditions found additional expert-confirmed findings for every condition tested, averaging approximately 40% enhanced detection. Radiologists using the models in investigational clinical use saw efficiency gains of more than 27% on CT and 31% on X-ray.
Publications
Research papers
 Read PDF · 14 pages
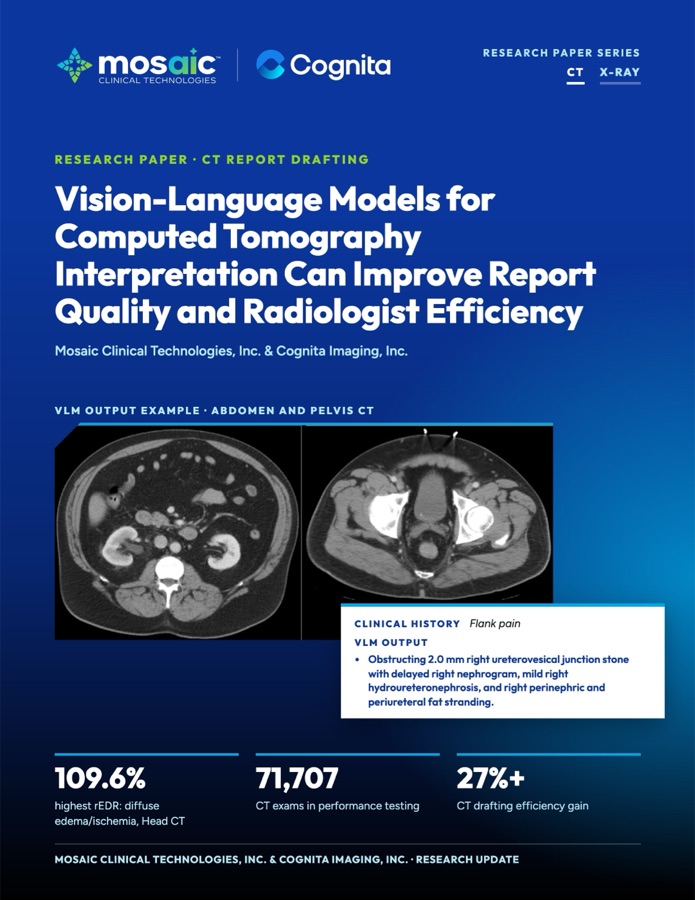
Research paper · CT report drafting
Vision-Language Models for Computed Tomography Interpretation Can Improve Report Quality and Radiologist Efficiency
Mosaic Clinical Technologies, Inc. & Cognita Imaging, Inc.
Retrospective performance testing on 71,707 CT exams of the head, cervical spine, chest, abdomen and pelvis across 35 conditions, plus real-world efficiency data.
 Read PDF · 12 pages
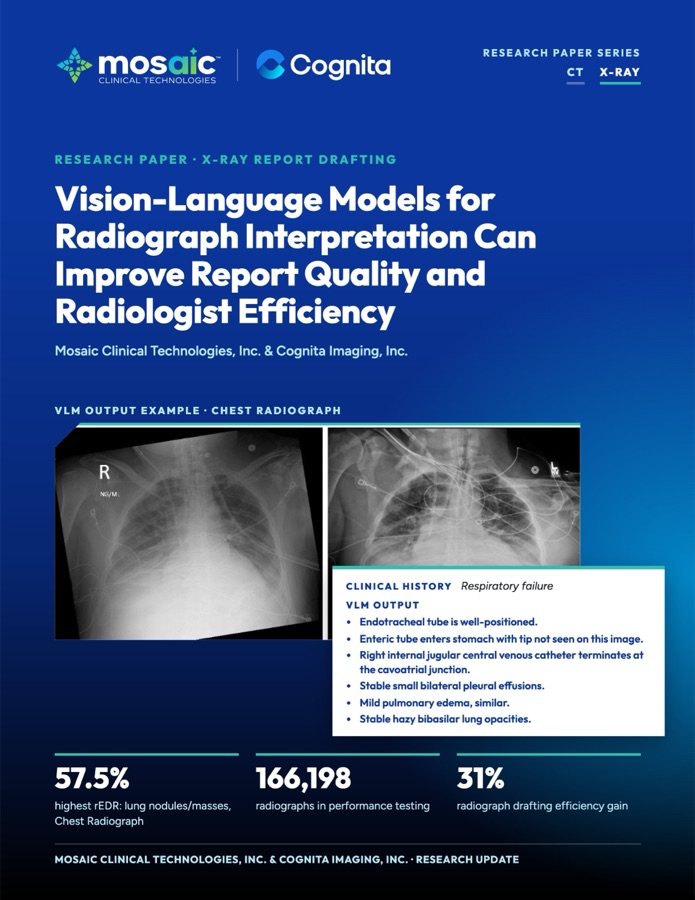
Research paper · X-ray report drafting
Vision-Language Models for Radiograph Interpretation Can Improve Report Quality and Radiologist Efficiency
Mosaic Clinical Technologies, Inc. & Cognita Imaging, Inc.
Retrospective performance testing on 166,198 chest, musculoskeletal and abdomen radiographs across 15 conditions, plus real-world efficiency data.
 Read PDF · 1 page
Research update · Summary
Results at a Glance
Mosaic Clinical Technologies, Inc. & Cognita Imaging, Inc.
A one-page summary of the headline results from both companion papers and how the study worked.
CAUTION: Investigational device. Not for sale in the United States.